有两件事经常一起被忽略:AI 抓取代理被 robots 挡在门外,以及站点没有给 AI 一份可直接读的目录。前者决定抓不抓得到,后者决定读完能不能快速定位到你最该被看到的内容。这两件事在我们后台分别对应 AI 爬虫放行矩阵 与 生成地图(llms.txt)。
本篇速览7 分钟 · 含放行矩阵与配置流程
一、llms.txt 是什么,写给谁看
它是放在站点根目录的一份纯文本「站点说明书」:一句话定位、主要栏目入口、重点内容索引。抓取方读完就能知道这个站是做什么的、重点内容在哪,不必先爬几百个页面再猜。它不是排名因子,也不保证被引用,作用是降低理解成本。
适合写进去的:核心栏目页、手册/专题入口、代表性的产品与案例、常见问题入口。不适合写进去的:全部文章列表(太长反而失去导航价值)。
二、一份 llms.txt 的标准结构
| 区块 | 写什么 | 示例要点 |
|---|---|---|
| 标题 | 站点名,一级标题 | # 品牌名 |
| 定位 | 一句话说明做什么、服务谁 | 引用格式,60–120 字 |
| 站点地址 | 正式域名(https) | 与 canonical 一致 |
| 关于本站 | 成立时间、所在地、业务边界 | 只写可核实事实 |
| 主要栏目 | 8–12 个核心入口 | - [栏目名](链接) |
| 内容索引 | 按栏目分组的重点内容 | 每组 5–8 条代表内容 |
| 结尾说明 | 声明用途与更新时间 | 写明「供 AI 助手理解站点结构」 |
写法要点:栏目用二级标题分组,内容用列表 + Markdown 链接;每条链接前写完整标题而不是编号,方便直接判断相关性。
三、常见 AI 抓取代理与放行建议
| 抓取代理 | 来自 | 建议 | robots 写法 |
|---|---|---|---|
| GPTBot | OpenAI | 放行 | User-agent: GPTBot / Allow: / |
| OAI-SearchBot | OpenAI 搜索 | 放行 | User-agent: OAI-SearchBot / Allow: / |
| ClaudeBot | Anthropic | 放行 | User-agent: ClaudeBot / Allow: / |
| PerplexityBot | Perplexity | 放行 | User-agent: PerplexityBot / Allow: / |
| Google-Extended | Google 生成式 | 按需 | User-agent: Google-Extended / Allow: / |
| ByteSpider | 字节系 | 按需(注意带宽) | 带宽紧张可限速或限制目录 |
别用一条
User-agent: * 把所有未知代理全拦掉:很多 AI 抓取会走通用代理,误拦等于自己把门关上。要限制的,是针对具体代理限制具体目录,而不是一刀切。四、配置流程:五步走完
1
盘点 robots 现状
先看有没有 Disallow: /、有没有拦截未知代理的兜底规则。
2
按矩阵放行
把需要放行的 AI 代理逐条写成 Allow,目录粒度按业务需要调整。
3
整理 llms.txt 内容
先定栏目入口,再挑各栏目的代表内容,控制在可读长度。
4
生成并核对
用后台生成地图产出 llms.txt 与 sitemap,打开根目录地址人工核一遍链接是否可访问。
5
内容更新后重生成
把「发完一批内容就重生成一次」写进流程,别让说明书停更。
五、后台怎么操作
爬虫放行矩阵 + 生成地图,两个页签搞定
放行在 AI 爬虫放行矩阵 里点选,llms.txt 与 sitemap 由 生成地图 统一产出,改完 robots 也在这里手工校正。
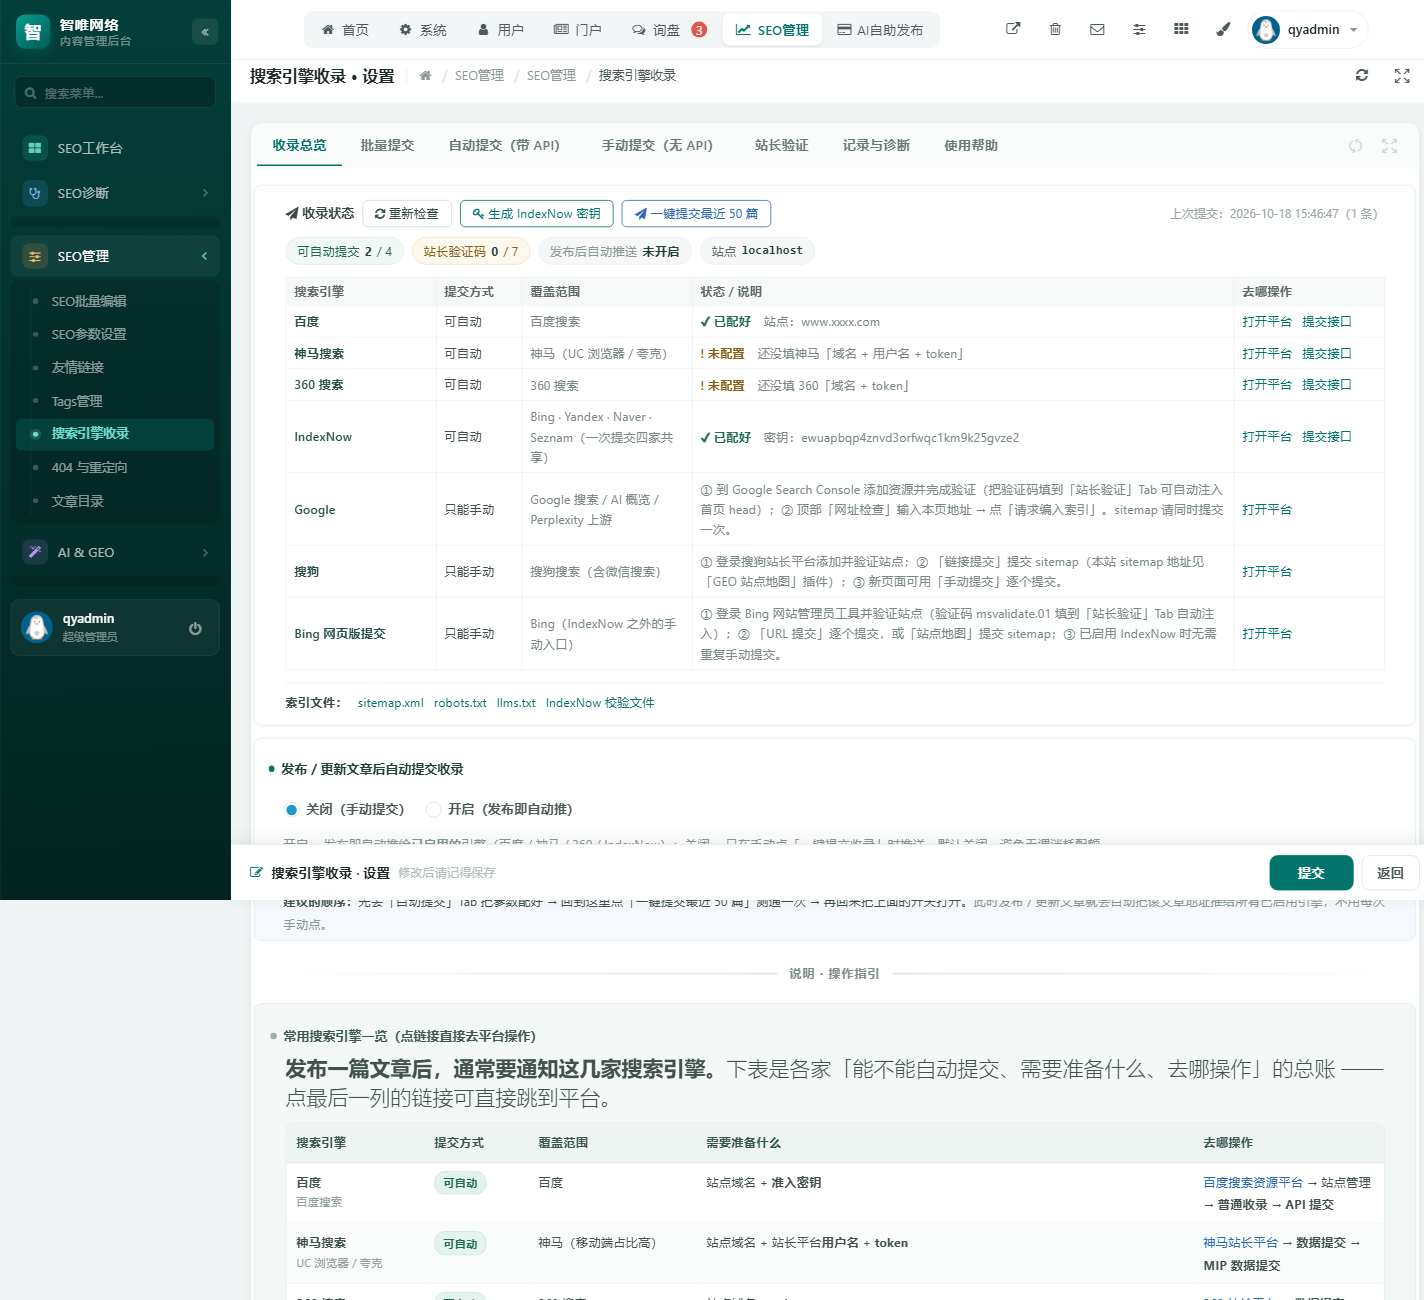
- 进 GEO 控制台 → AI 爬虫放行矩阵,逐条确认主流代理状态,被误拦的点开改成放行;
- 需要手工微调时到 robots 编辑区,按「具体代理 + 具体目录」写规则,避免一刀切;
- 进 生成地图,重生成 sitemap 与 llms.txt;
- 浏览器打开
/llms.txt与/robots.txt,逐条点链接确认可访问; - 新内容成批上线后,回到这里再生成一次,并顺手提交收录。
六、上线前自查
robots 没有兜底全拦:不存在拦截所有未知代理的规则。
主流 AI 代理已放行:至少 GPTBot / ClaudeBot / PerplexityBot 在 Allow 名单。
llms.txt 可访问:根目录能打开,链接全部 200。
栏目入口齐全:核心栏目都在,没有遗漏主手册 / 报价 / 案例。
有更新机制:批量发文后会重生成,而不是一次生成后不管。
llms.txt 要手写维护
读完这篇,你可能会想「这些我能不能逐项买」——可以,但没必要。下面这些能力在我们交付的系统里已经内置,上线登录后台就能用,多数建站公司不提供,或作为按年收费的增值项。
- 常见情况:写完就过期,没人负责更新。
- 我们的系统:生成地图自动产出 sitemap 与 llms.txt,随内容更新。
- 怎么开始:把行业、目标市场和大概预算发给我们,顾问帮你圈定档位与功能清单,先看方案再决定做不做。
具体能力按所选档位开通;我们交付符合规范的结构与内容,不承诺排名,也不承诺被 AI 引用。