一、它能帮你做什么WHY
GEO(生成式引擎优化)= 让你的网站在 AI 回答里被引用。控制台把这件事拆成 9 个分区,一个页面管到底(日常主线 ①–⑤,进阶配置 ⑥–⑨):
| 分区 | 管什么 | 一句话理解 |
|---|---|---|
| ① 生成地图 | 一键产出 sitemap.xml / sitemap.txt / robots.txt / llms.txt | 告诉搜索引擎与 AI「我有哪些页面、什么该抓」 |
| ② 地图与爬虫 | sitemap 状态 + AI 爬虫放行矩阵 + robots.txt 在线编辑 | 18 个主流 AI 爬虫,放行 / 拦截一目了然 |
| ③ GEO 体检 | 13 类检查项,只读打分(A~E 等级) | 域名、实体一致性、llms.txt、抓取实测……逐项给「去处理」 |
| ④ 结构化数据 | JSON-LD 覆盖扫描 | 逐页核对结构化数据是否真的输出了、字段齐不齐 |
| ⑤ 爬虫趋势 | AI 引擎抓取统计 + 日志补录 | AI 到底来抓过没有、抓了什么,有数可查 |
顺带说明:早期的「站点地图」「AI 爬虫分析」两个独立菜单已并入本控制台(① 和 ⑤),旧链接会自动跳转过来,不用另外找。本页现共 9 个分区:⑥ 站外权威、⑦ 品牌实体、⑧ 输出设置、⑨ 实操指南 属进阶 / 配置分区,界面自带说明,按需打开即可。本页现共 9 个分区:⑥ 站外权威、⑦ 品牌实体、⑧ 输出设置、⑨ 实操指南 属进阶 / 配置分区,界面自带说明,按需打开即可。
它做不到的事:它不会替你向搜索引擎提交收录(那在「搜索引擎收录」页)、也不会改文章内容(那在 AI 内容助手)。控制台只负责「地图、放行、体检、数据、观测」。
二、三分钟上手QUICK START
新站上线或换域名后,照这四步做一遍,对外文件就全部就位。
1. 填「对外正式域名」
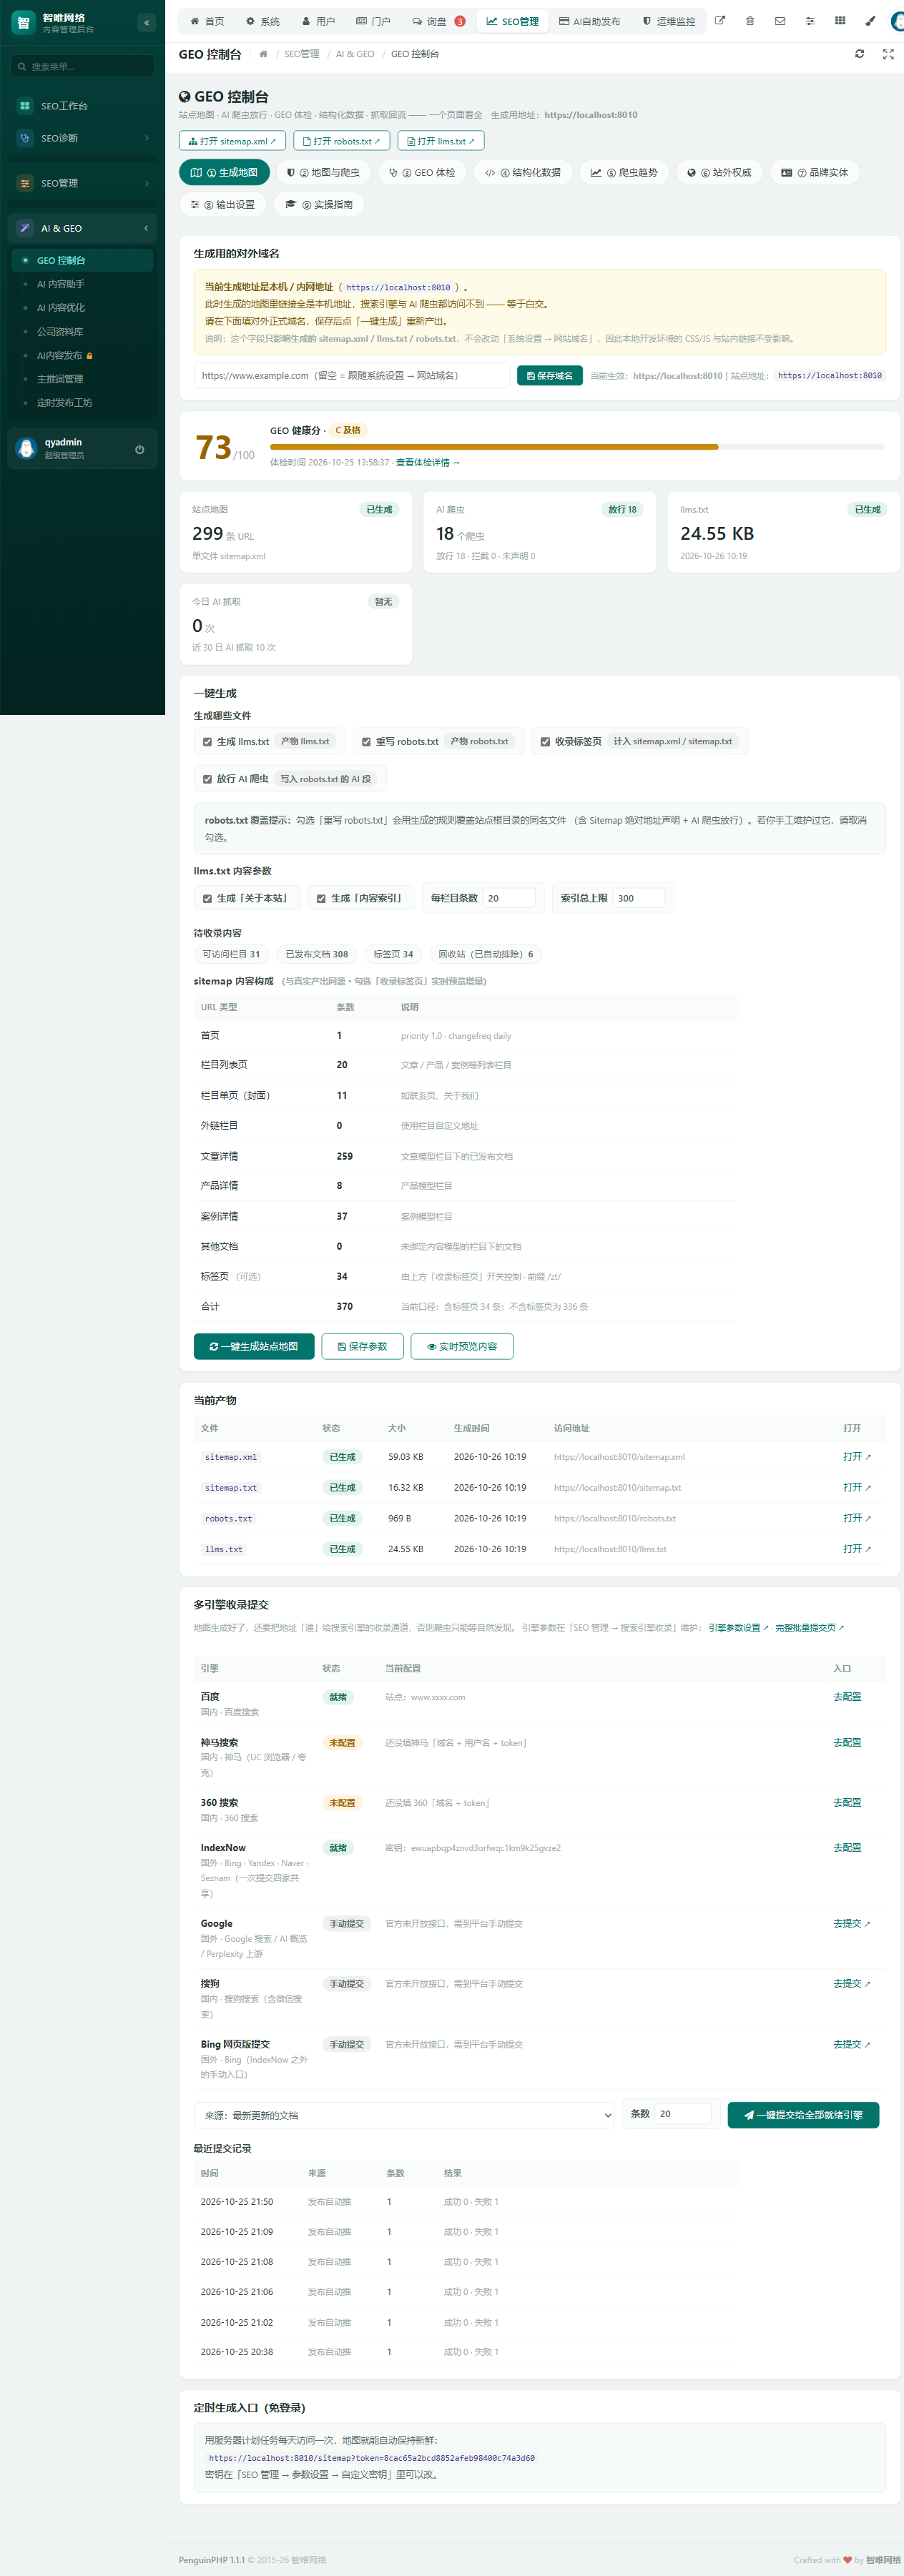
页签① 顶部填你的线上域名并保存。本地 / 内网地址生成的地图外部访问不到,等于白交。
2. 点「一键生成站点地图」
默认勾选生成 llms.txt、重写 robots.txt、放行 AI 爬虫。生成后下方「当前产物」表格逐个显示文件状态。
3. 抽查三个文件
点右上角「打开 sitemap.xml / robots.txt / llms.txt」确认链接都是正式域名。
4. 跑一次「GEO 体检」
页签③ 点「立即体检」,按「去处理」清单逐项解决,分数与等级会随改动提升。
跟 AI 助手下指令时,可以直接说:
后台 GEO 控制台帮我重新生成一遍站点地图,域名用 bfm8z.com,生成完跑一次 GEO 体检,把警告项列给我。
三、九个分区怎么用TOUR
3.1 ① 生成地图 —— 一键产出对外四件套
- 生成哪些文件:llms.txt(给 AI 的站点说明)、重写 robots.txt、收录标签页;
- llms.txt 内容参数:是否生成「关于本站」「内容索引」、每栏目条数、索引总上限;
- 待收录范围:自动统计可访问栏目、已发布文档、标签页,回收站内容自动排除;
- 当前产物:每个文件的 状态 / 大小 / 生成时间 / 访问地址,点「打开」即看。
robots.txt 覆盖提示:勾选「重写 robots.txt」会用生成的规则覆盖站点根目录同名文件(写入 Sitemap 绝对地址 + AI 爬虫放行)。如果你手工维护过它,请取消勾选,避免被覆盖。
「对外正式域名」只影响生成的 sitemap.xml / llms.txt / robots.txt,不会改动系统设置里的网站域名,本地开发环境的 CSS / JS 与站内链接不受影响。
3.2 ② 地图与爬虫 —— 谁能来抓,一目了然
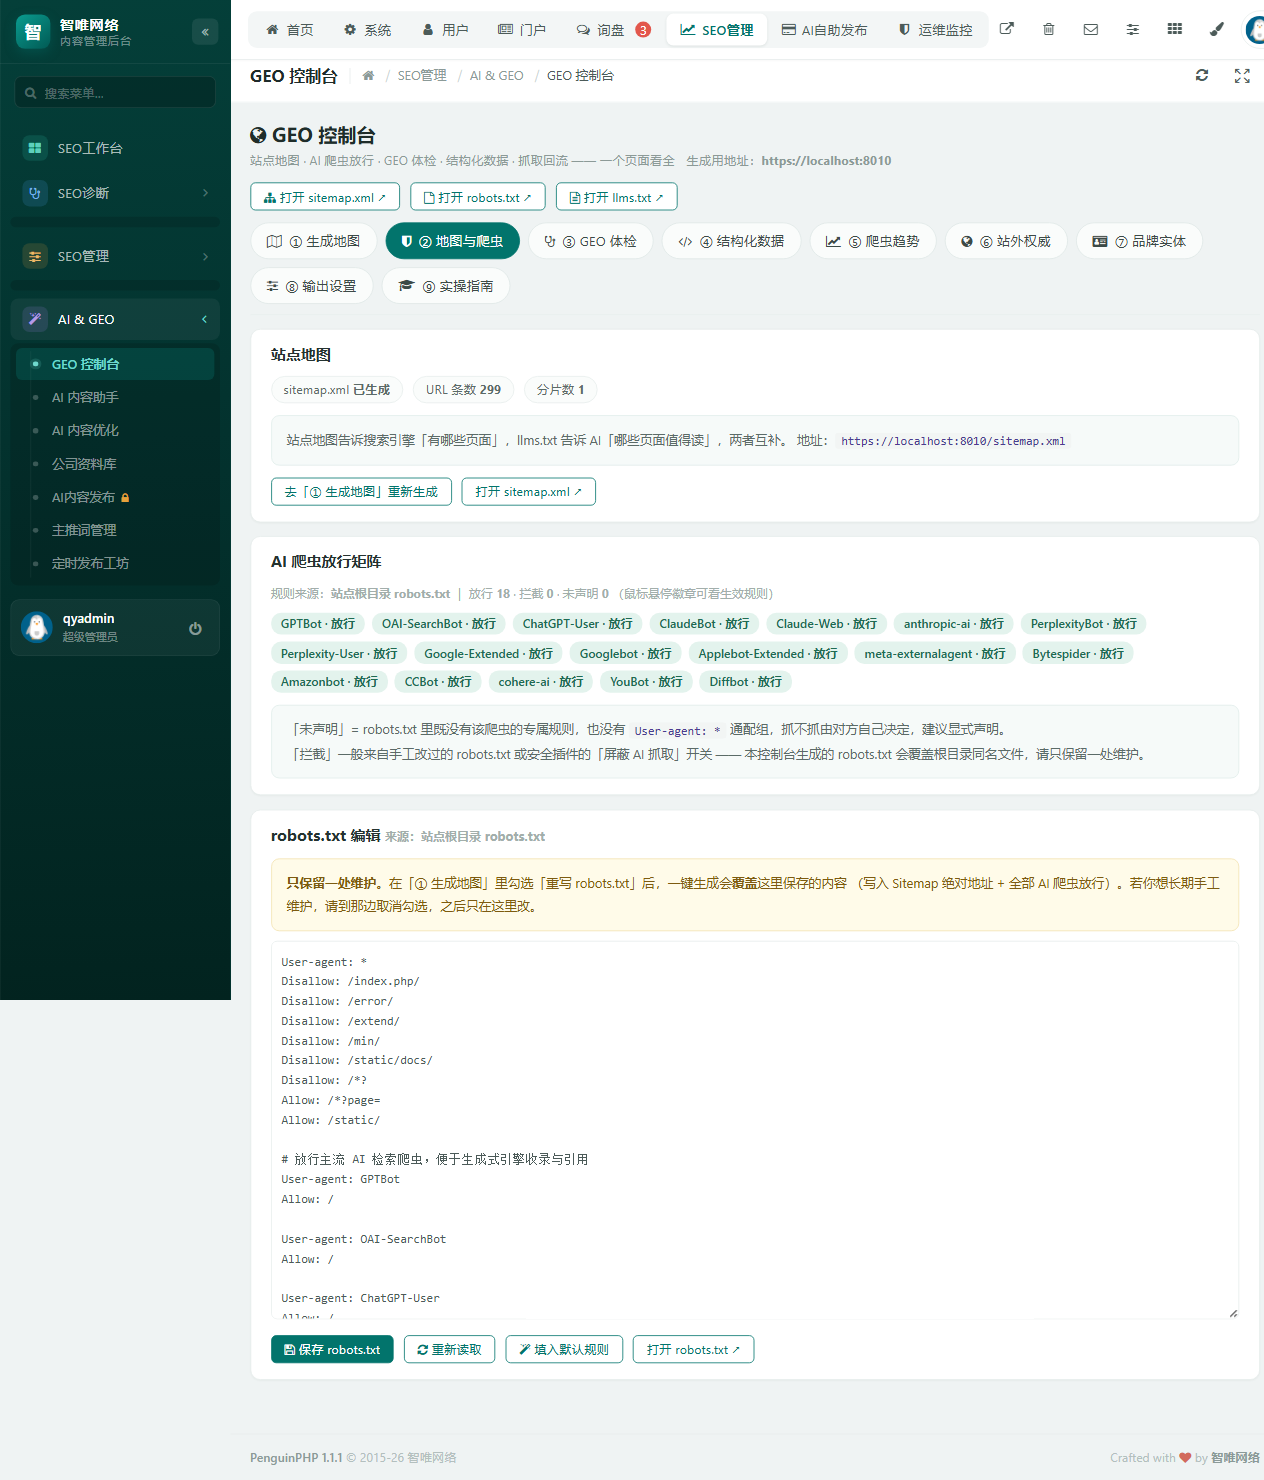
- AI 爬虫放行矩阵:GPTBot、OAI-SearchBot、ClaudeBot、PerplexityBot、Google-Extended、Bytespider 等 18 个爬虫逐个显示放行 / 拦截 / 未声明,鼠标悬停徽章可看生效规则;
- 「未声明」:robots.txt 里没有该爬虫的专属规则也没有通配组,抓不抓由对方自己决定 —— 建议显式声明;
- 「拦截」:一般来自手工改过的 robots.txt 或安全插件的「屏蔽 AI 抓取」开关。本控制台生成的 robots.txt 会覆盖根目录同名文件,请只保留一处维护;
- robots.txt 在线编辑:可直接改,支持「重新读取 / 填入默认规则」。
3.3 ③ GEO 体检 —— 只读打分,逐项给出口
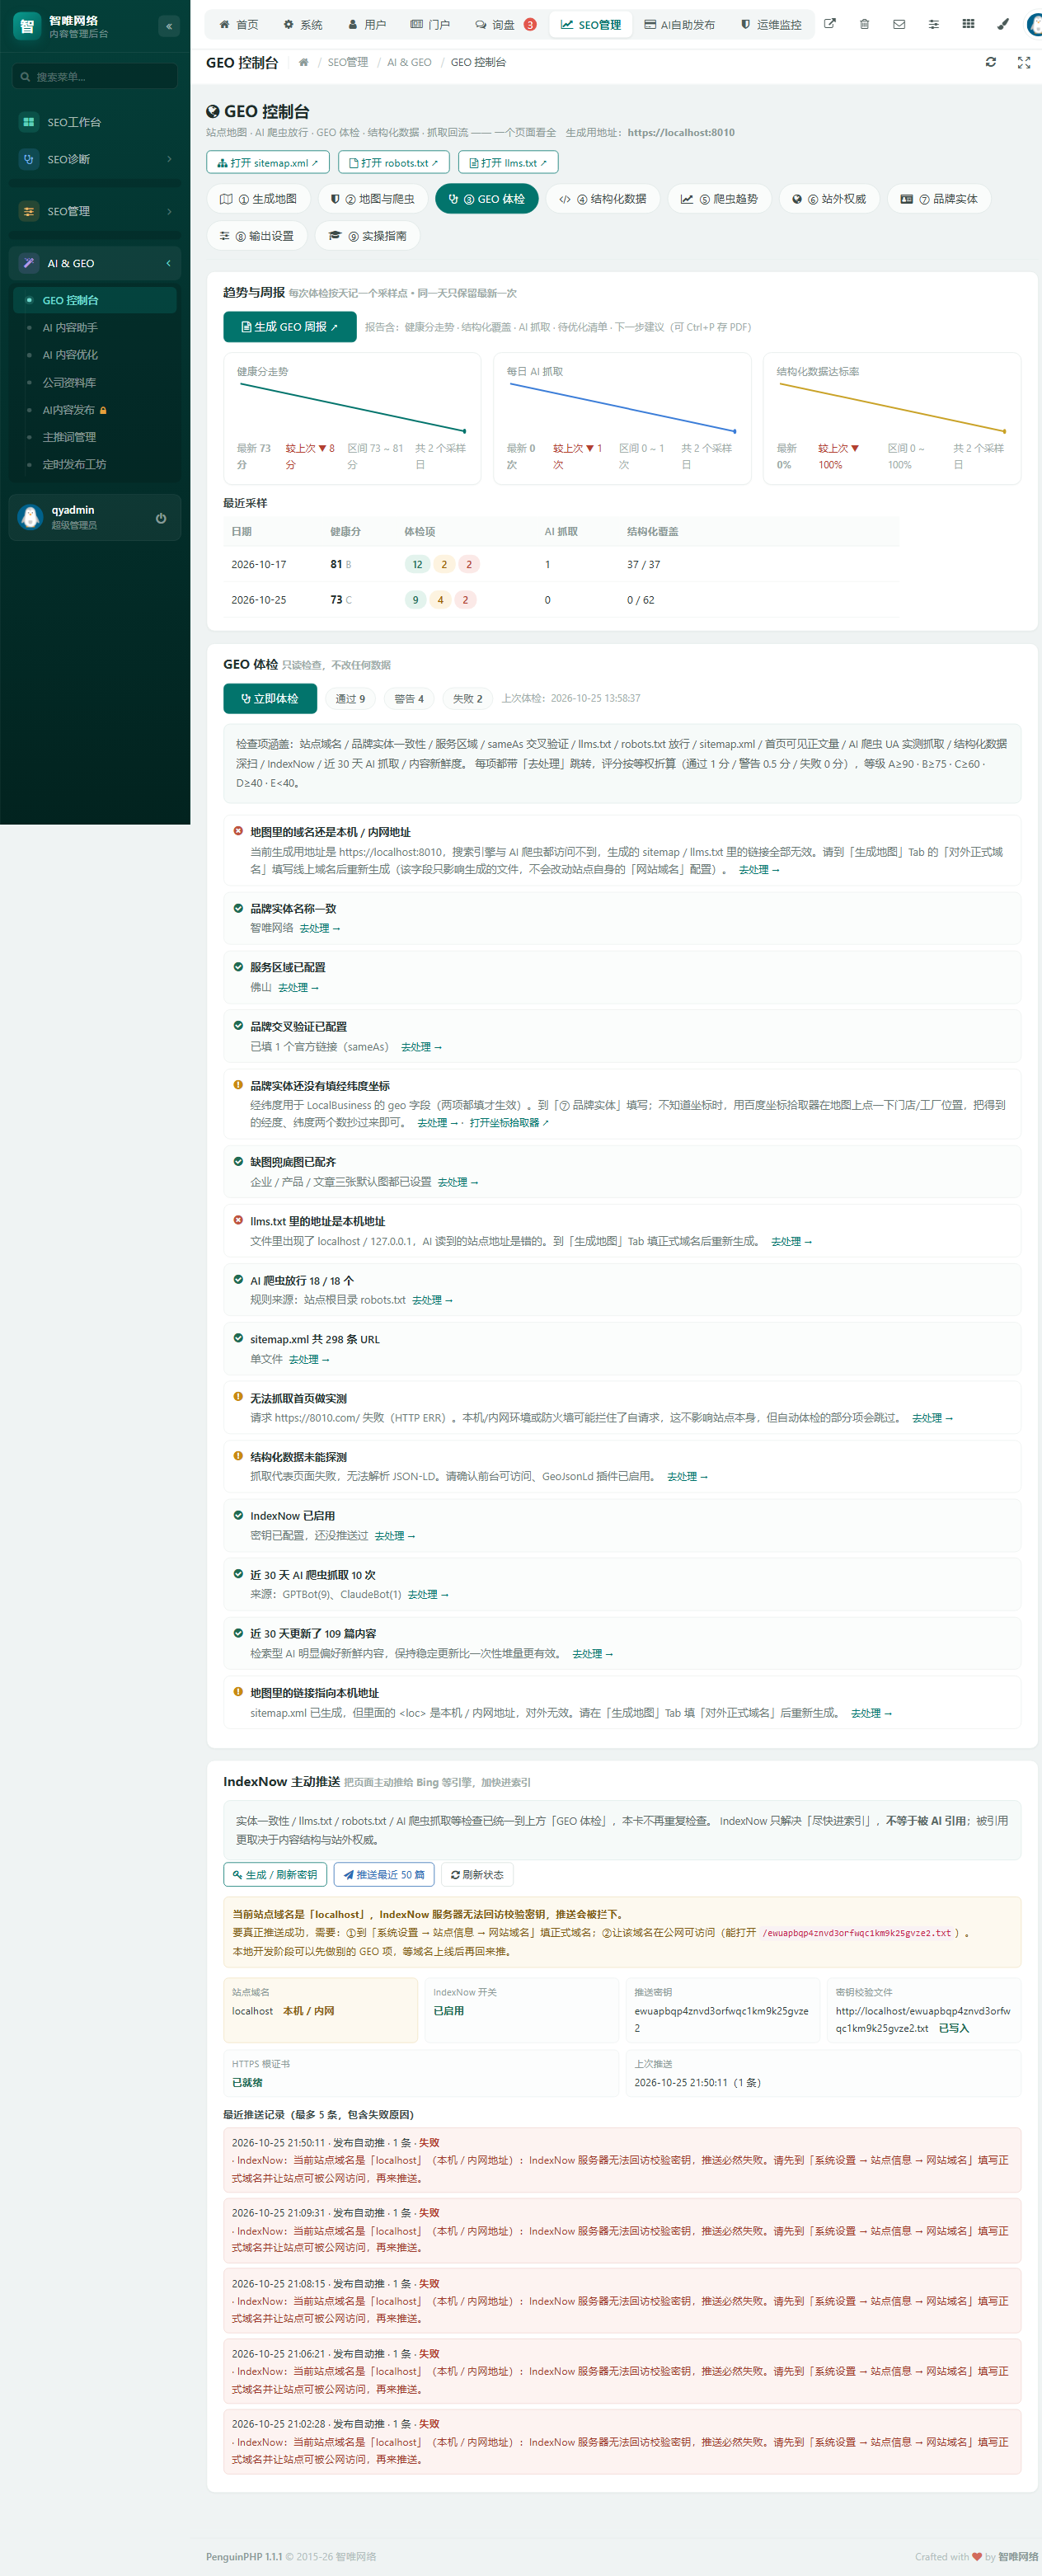
检查项涵盖:站点域名 / 品牌实体一致性 / 服务区域 / sameAs 交叉验证 / llms.txt / robots.txt 放行 / sitemap.xml / 首页可见正文量 / AI 爬虫 UA 实测抓取 / 结构化数据深扫 / IndexNow / 近 30 天 AI 抓取 / 内容新鲜度。评分按等权折算(通过 1 分 / 警告 0.5 分 / 失败 0 分),等级 A≥90 · B≥75 · C≥60 · D≥40 · E<40。整页只读,不会改任何数据。
3.4 ④ 结构化数据 —— JSON-LD 覆盖扫描
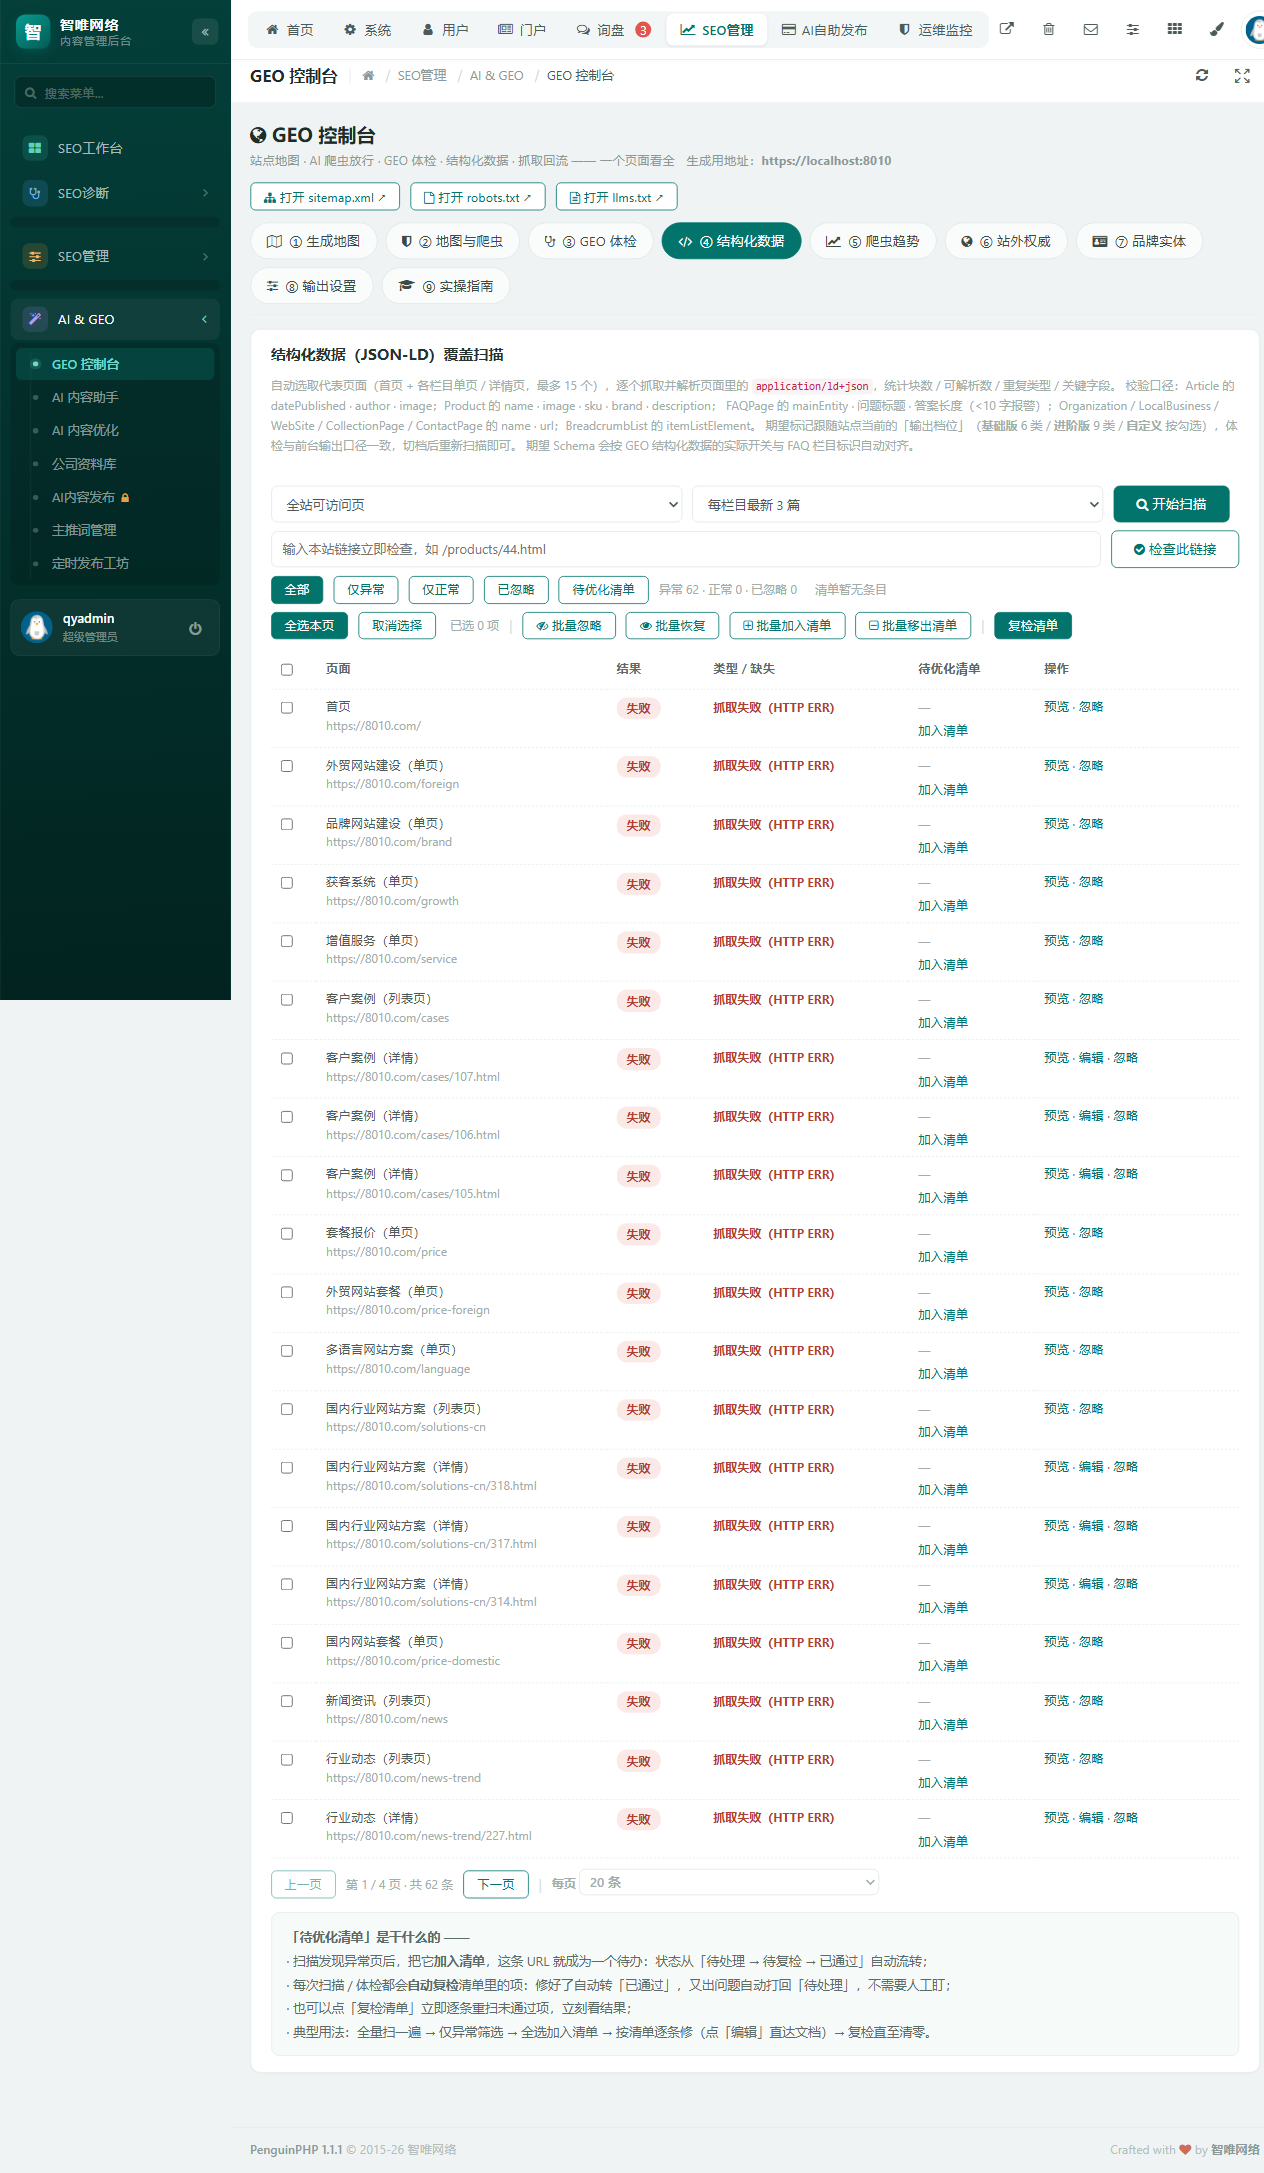
扫描统计每页的 JSON-LD 块数 / 可解析数 / 重复类型 / 关键字段(Article 的 datePublished · author · image,Organization 的 name · url)。实体配置(企业信息 / 品牌名 / 服务区域 / sameAs 社交资料交叉引用)在 GeoJsonLd 插件设置里改,点「到插件设置」直达。
3.5 ⑤ 爬虫趋势 —— AI 到底来没来
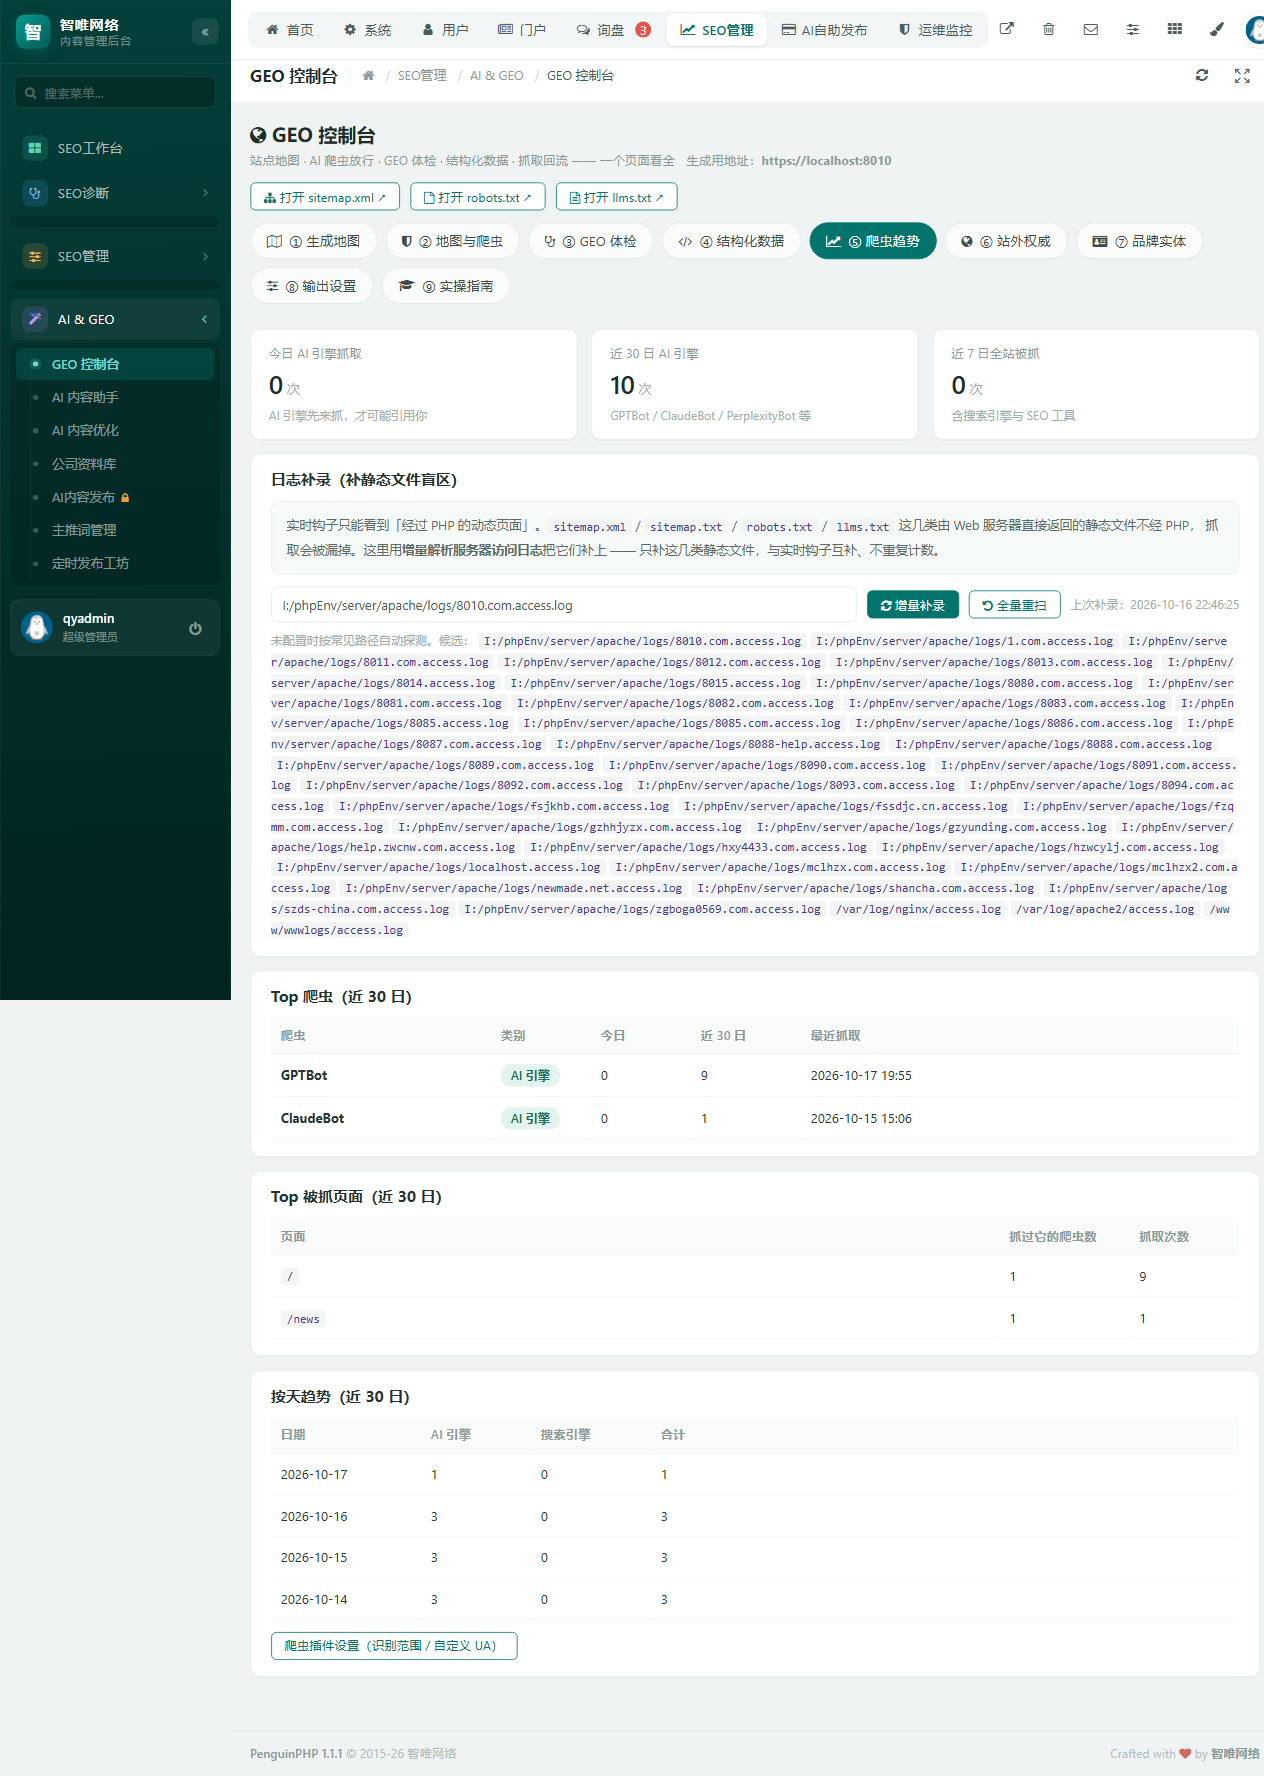
为什么有「日志补录」:实时钩子只能看到经过 PHP 的动态页面;sitemap.xml / robots.txt / llms.txt 这类由 Web 服务器直接返回的静态文件不经 PHP,抓取会被漏掉。补录用增量解析服务器访问日志把这几类补上,与实时钩子互补、不重复计数。
四、对外文件速查FILES
一键生成后,站点根目录会有这几个对外文件,各有分工:
| 文件 | 给谁看 | 作用 |
|---|---|---|
/sitemap.xml | 搜索引擎 | 全站 URL 清单(含最后更新时间),提交收录的主依据 |
/sitemap.txt | 搜索引擎(简易格式) | 纯文本 URL 列表,兼容部分平台的简单提交入口 |
/robots.txt | 所有爬虫 | 抓取规则:Sitemap 声明 + AI 爬虫逐个放行 |
/llms.txt | AI 引擎 | 「关于本站 + 内容索引」,帮 AI 快速理解站点结构与重点内容 |
/<32 位密钥>.txt | IndexNow 校验 | 收录推送的密钥校验文件(在「搜索引擎收录」页生成) |
改动后要重新生成吗:新增 / 删除文章、栏目、标签后,回到页签① 再点一次「一键生成」即可,几秒钟完成。
五、常见问题 FAQFAQ
1. 生成的 sitemap 里链接是 localhost / 内网地址?
页签① 顶部「对外正式域名」还没填。填线上域名 → 保存 → 重新一键生成。这个字段只影响生成的对外文件,不影响站点自身配置。
2. 我手工维护 robots.txt,会被覆盖吗?
只在页签① 勾选了「重写 robots.txt」时才会覆盖。长期手工维护的话取消勾选;要改就只在②的编辑器里改,别两处同时维护。
3. 「未声明」的爬虫需要处理吗?
建议处理。未声明 = 对方自行决定抓不抓。在本控制台重新生成一次 robots.txt,即可把 18 个主流 AI 爬虫显式放行。
4. 体检分不高,从哪下手?
优先处理「失败」项(红色),再清「高优先级警告」。每一项都带「去处理 →」直达对应页面,改完点「立即体检」复评。常见三件:填正式域名、GeoJsonLd 补品牌名与服务区域、跑一次一键生成。
5. 体检说「品牌名回落站点标题」是什么意思?
GeoJsonLd 的「品牌名称」为空时,结构化数据会拿站点标题兜底。AI 更容易把「显式声明的品牌名」锁定为同一实体,建议到 GeoJsonLd 插件设置里填公司 / 品牌名、服务区域和 sameAs。
6. AI 抓取次数是怎么统计的?会不会漏?
两部分相加:实时钩子(经过 PHP 的动态页面)+ 日志补录(sitemap / robots / llms 等静态文件)。静态文件那部分记得在⑤里点过「增量补录」,或保持自动探测的日志路径有效。
7. 原来的「站点地图」「AI 爬虫分析」菜单去哪了?
已分别并入本控制台的①和⑤,旧链接自动跳转,功能没有减少。
六、找不到答案怎么办SUPPORT
文档没覆盖到的情况,按下面这样反馈,我们能最快定位。
- 说明是哪个页签、哪一步(例:①生成地图 → 点一键生成后产物表格没有刷新);
- 把GEO 体检对应检查项的名称与「当前值」发过来(例:品牌实体一致性 · 当前值:智唯网络);
- 涉及生成文件时,附上对应文件的访问地址(sitemap.xml / robots.txt / llms.txt)。
小技巧:③GEO 体检的每一项自带「为什么重要、怎么处理」,把那一项整段截图发来,基本一眼就能判断。